(資料庫系統) Basic SQL (Structured Query Language)
簡短說明:
- 主題:Basic SQL
- 本章重點:
- SQL 的由來與「關聯模型」差異
- SQL 三種語言:DDL / DML / DCL
- Schema / Catalog / CREATE TABLE
- 資料型態 & Domain
- 各種 Constraints(PK / FK / UNIQUE / NOT NULL / CHECK / DEFAULT)
- 基本查詢:SELECT-FROM-WHERE、DISTINCT、集合運算
- INSERT / DELETE / UPDATE 修改資料
Basic SQL & 關聯模型差異
SQL的由來
-
起源:從 tuple calculus(關聯謂詞演算)發展出語言 SQUARE → SEQUEL → SQL
-
SQL 原本是 SEQUEL to SQUARE 的縮寫,後來因版權改成 SQL(Structured Query Language)
→ 目前都習慣叫「Structured Query Language」。
名詞對照(數學 vs 實作)
理論的關聯模型使用比較「數學」的名稱:
| 關聯模型 | SQL 實務名稱 | 中文 |
|---|---|---|
| Relation | Table | 資料表 |
| Tuple | Record / Row | 紀錄/列 |
| Attribute | Field / Column | 欄位/行 |
- SQL可以不需定義主鍵
- SQL資料表可以有兩筆序列值一模一樣
- 資料表中的紀錄是有次序的
SQL 提供的三種語言
DDL(Data Definition Language)
用途:定義資料庫結構 & 各種物件
- 物件:Database、Table、View、Index、Schema、Domain、Stored Procedure、Trigger…等
- 常見指令:
- CREATE:建立物件(table、schema、view、index…)
- ALTER:變更物件(加欄位、改 constraint…)
- DROP:刪除物件
DML(Data Manipulation Language)
用途:操作資料表的資料
- 常見指令:
- INSERT:新增資料
- UPDATE:修改資料
DCL(Data Control Language)
用途:權限控制 & 交易控制
- 常見指令:
- GRANT:給使用者權限
- REVOKE:收回權限
- COMMIT:提交交易(真的寫進 DB)
- ROLLBACK:異常時回復到交易開始前的狀態
- DELETE:刪除資料
小抄:
DDL:建東西 → CREATE / ALTER / DROP
DML:改資料 → INSERT / UPDATE / DELETE
DCL:權限+交易 → GRANT / REVOKE / COMMIT / ROLLBACK
Schema & Catalog & CREATE TABLE
Schema 概念
- SQL schema:
- 有一個 schema 名稱
- 有一個授權識別碼(帳號 / 使用者),表示誰是 owner
- 裡面包含各種元素:tables、constraints、views、domains 等
- 建立語法:
Each statement in SQL ends with a semicolon(;)
1 | CREATE SCHEMA COMPANY AUTHORIZATION 'Jsmith'; |
→ 建一個 schema 叫 COMPANY,擁有者是 Jsmith。
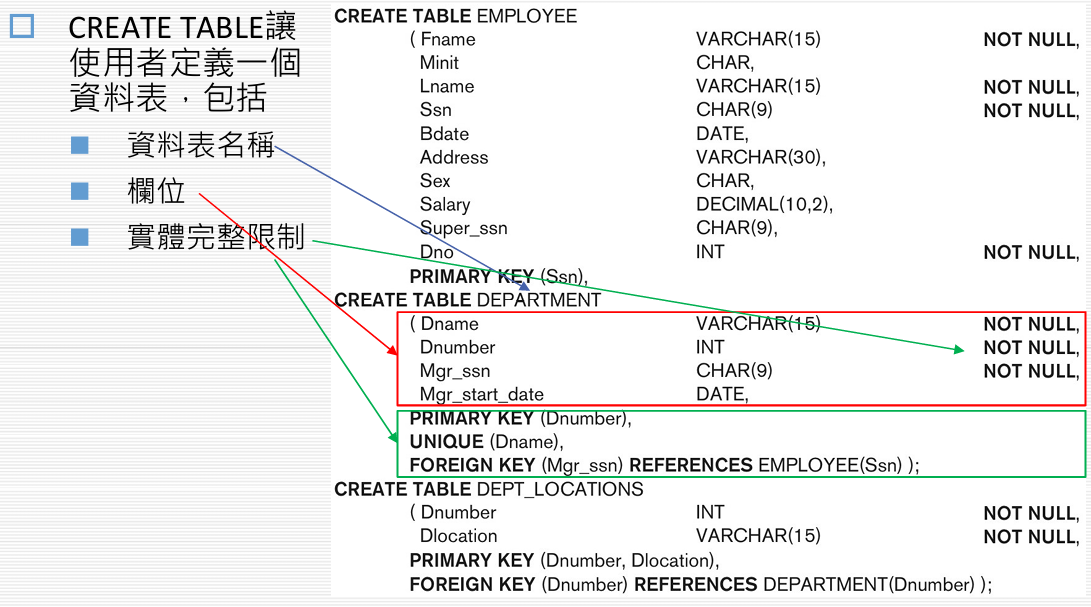
CREATE TABLE:定義資料表
- 目的:定義一個 base table(基礎關聯)
- CREATE TABLE 建立的是 base table:
- 真正會在磁碟上建立檔案來存 row
- 若是 CREATE VIEW 則是 virtual relation(view):
- 不對應實體檔案,只是查詢的視圖
1 | CREATE TABLE EMPLOYEE ( |
欄位:欄位名 資料型態 [NOT NULL] [DEFAULT …] [CHECK(…)]
下方可以定義:PRIMARY KEY、UNIQUE、FOREIGN KEY 等 constraint
Catalog 概念
- Catalog : 一個SQL environment中,很多個schema的集合。
資料型態 & Domain
數值型態(Numeric Types)
整數型態
INT、INTEGER:整數- 無小數位、不可表示浮點
小數型態(定點數)
DECIMAL(i, j)、NUMERIC(i, j)、DEC(i, j)i:總位數(precision)j:小數位數(scale)
例:
DECIMAL(3,1)→ 例如12.5DECIMAL(5,2)→ 例如123.45
若未指定
(i, j),則使用 DBMS 預設值。
字串型態(Character Types)
固定長度字串
1 | CHAR(n) |
儲存長度不足會自動補空白(padding)
可變長度字串
1 | VARCHAR(n) |
- 最長 n 個字元
- 實務上幾乎都用 VARCHAR
- 在支援 Unicode 的 DBMS 中,一個中文字通常算一個字元,否則兩個。
Bit 串與 Boolean
Bit-string data types
- BIT(n):固定長度 bit
- BIT VARYING(n):可變長度 bit
Boolean data types
- TRUE / FALSE / NULL
DATE data type
- Ten positions
- YEAR,MONTH,DAY in form YYYY-MM-DD
TIME data type
- 標準的時間欄是
- hh:mm::ss
1 | TIME |
- 範例:
- TIME ‘13:45:59’
- TIME ‘13:45:59.25’ – 小數秒
Timestamp(DATETIME) data type
1 | TIMESTAMP |
- 代表日期 + 時間
- 2024-01-06 13:22:11
INTERVAL(時間區間)
- INTERVAL 表示一段相對的時間,可加入 DATE / TIMESTAMP 使用:
1 | DATE '2024-01-01' + INTERVAL '15' DAY |
BLOB / CLOB(大型物件)
BLOB Data Type (Binary Large Object)
- 存大型二進位資料:例如圖片、音檔、影片、PDF…
CLOB Data Type (Character Large Object)
- 存大型文字資料:例如整份文章、長篇內容、log、JSON 文字
Domain / TYPE(自訂型態)
Domain
-
定義一個 domain,很多欄位都可以用它;以後你想改型態/規則,就改 domain 即可
1
CREATE DOMAIN SSN_TYPE AS CHAR(9);
- 也可以加 CHECK:
1
CREATE DOMAIN SALES_TYPE INT CHECK (SALES_TYPE > 100);
TYPE(UDT:User Defined Type)
- 這是偏物件導向/複合型資料用的,指令是
CREATE TYPE
Specifying Constraints in SQL
SQL 支援的「三大基本約束」
- Key constraint(鍵限制)
- 主鍵不能重複(primary key value cannot be duplicated)
- Key 值是唯一的
- Entity integrity(實體完整性)
- 主鍵不能是 NULL(primary key value cannot be null)
- Primary Key值不得為空
- Referential integrity(參考完整性)
- 外鍵要嘛是 NULL,要嘛必須能對到對方表的主鍵
- 當Foreign Key 有值時,要參考的到
欄位層級的限制(DEFAULT / NOT NULL / CHECK)
DEFAULT
- 你沒填值時,系統自動帶入預設值:
DEFAULT <value>
NOT NULL
- 這個欄位不允許 NULL
CHECK
- 用條件限制欄位值(或多欄位的邏輯)
Dnumber INT NOT NULL CHECK (Dnumber > 0 AND Dnumber < 21);- 寫進Domain :
CREATE DOMAIN D_NUM AS INTEGER CHECK (Dnumber > 0 AND Dnumber < 21);
PRIMARY KEY
- 指定一個或多個欄位組成主鍵
- 主鍵含義=唯一 + 不可為 NULL(對應前面 key + entity integrity)
UNIQUE
- 指定「候選鍵/替代鍵」(candidate key / alternate key)
- 一樣要求「值不重複」,但通常可以允許 NULL(依 DBMS 有差)
- 投影片例:Dname VARCHAR(15) UNIQUE;
PRIMARY KEY:一張表通常選 1 個(可複合)當“主要識別”
UNIQUE:其他也能唯一識別的欄位(候選鍵)
FOREIGN KEY 基本概念
- 預設行為:違反參考完整性就 reject(拒絕)
- 可以加上「參考觸發動作」
- 常見選項:SET NULL, CASCADE, SET DEFAULT
- DBMS 對 SET NULL 或 SET DEFAULT,在 ON DELETE 與 ON UPDATE 的處理邏輯是一樣的(都是把子表 FK 欄位改成 NULL 或預設)
- 什麼情況適合 CASCADE?
- 表示「關係」的表
- 表示多值屬性的表
- 表示弱實體的表
ON DELETE / ON UPDATE 各種動作
ON DELETE …
- RESTRICT(預設):父表那筆記錄「沒被參考」才能刪
- SET NULL:父表刪了 → 子表所有參考它的 FK 全部改成 NULL
- SET DEFAULT:父表刪了 → 子表所有參考它的 FK 全部改成預設值
- CASCADE:父表刪了 → 子表所有參考它的那些資料列也跟著刪
ON UPDATE …
- RESTRICT(預設):父表主鍵「沒被參考」才能改
- CASCADE:父表主鍵改了 → 子表所有參考它的 FK 也跟著改
Constraint 命名與修改(Giving Names to Constraints)
為什麼要幫 Constraint 取名字?
- 使用關鍵字
CONSTRAINT - 好處:
- 之後 ALTER TABLE 修改或刪除 constraint 時會非常方便
- 不用依賴 DBMS 自動產生的亂碼名稱
- ALTER TABLE 也可以用來
修改完整性限制,包括完整限制的刪除和新增
範例:在 CREATE TABLE 時命名
1 | CREATE TABLE Browse ( |
使用 ALTER TABLE 修改 Constraint
-
ALTER TABLE 可以:
- 新增 constraint
- 刪除 constraint
- 刪除 constraint 一定要知道它的名字
-
刪除 Constraint
1
2ALTER TABLE Browse
DROP CONSTRAINT mIdFK; -
新增 Constraint
1
2
3
4
5
6ALTER TABLE Browse
ADD CONSTRAINT NewmIdFK
FOREIGN KEY (mId)
REFERENCES Member(mId)
ON DELETE CASCADE
ON UPDATE CASCADE; -
若一開始忘記命名 constraint:
1
SHOW CREATE TABLE Browse;
Default 值與 Referential Integrity 搭配
DEFAULT + FOREIGN KEY
- 當外鍵設定
ON DELETE SET DEFAULT - 該欄位 一定要有 DEFAULT 值
Tuple 層級的限制(CHECK on Tuples)
Table-level CHECK(跨欄位檢查)
- CHECK 不只可以限制「單一欄位」
- 也可以限制「同一筆 tuple 內,多個欄位的邏輯關係」
- 寫在 CREATE TABLE 最後面
- 範例:
1
CHECK (Dept_create_date <= Mgr_start_date);
每一筆資料都必須滿足:
部門成立日 ≤ 經理上任日
否則 INSERT / UPDATE 會被拒絕
Basic Retrieval Queries(基本查詢)
SELECT 語句基本概念
- SELECT 是 SQL 中 唯一的查詢語句
- 用來從資料庫「取資料」而非修改資料
- SQL 與關聯模型的差異
- SQL 允許重複的 tuple
- 因此 SQL 是: **Bag(Multiset)**語意
- 關聯模型 是 : **Set(集合)**語意
SELECT–FROM–WHERE 基本結構
1 | SELECT <attribute list> |
SELECT:要顯示的欄位(Projection)
FROM:資料來源表格
WHERE:篩選條件(Selection)
WHERE 常用比較運算子
- =, <, <=, >, >=, <>
- 條件必須是 Boolean expression
基本查詢範例說明
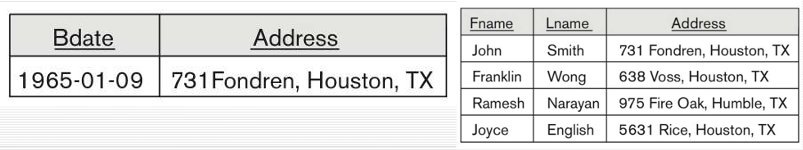
- 取得名為 John B. Smith 的員工生日與地址
1 | SELECT Bdate, Address |
- 查 Research 部門所有員工姓名與地址
1 | SELECT Fname, Lname, Address |
- 多表 Join(Project / Department / Employee)
- 查詢位於 Stafford 的專案:
- 專案編號
- 部門編號
- 部門經理的姓名、地址、生日
1 | SELECT Pnumber, Dnum, Lname, Address, Bdate |
Ambiguous Attribute Names(屬性名稱歧義)
-
不同資料表中 欄位名稱相同
在 SELECT / WHERE 中無法判斷是誰的欄位 -
Solution : Qualified Attribute Name
- RelationName.AttributeName
-
範例:
1
2
3
4SELECT Fname, EMPLOYEE.Name, Address
FROM EMPLOYEE, DEPARTMENT
WHERE DEPARTMENT.Name = 'Research'
AND DEPARTMENT.Dnumber = EMPLOYEE.Dnumber;
Aliasing 與 Renaming(別名 / 重新命名)
Alias(tuple variable)
- 同一張表在同一個查詢裡要用 兩次以上(self-join)時,一定要取別名,不然欄位會混在一起。
- 別名也能讓 SQL 變短、可讀性更好。
範例:員工 vs 主管(同一張 EMPLOYEE 用兩次)
- 目標:對每位員工,取出員工的姓名與「直屬主管」的姓名
1 | SELECT E.Fname, E.Lname, S.Fname, S.Lname |
E:代表員工本人那一份 EMPLOYEE
S:代表主管那一份 EMPLOYEE
E.Super_ssn = S.Ssn:把員工的主管代碼對到主管的主鍵
AS 在多數 DBMS 可以省略
欄位也可以改名(Rename attributes)
- 在結果欄位用 AS 改欄名(常用、最實際)
1 | SELECT E.Fname AS EmpFname, E.Lname AS EmpLname |
沒寫 WHERE 與星號 *
Missing WHERE
- 沒有篩選條件 → 等同「WHERE TRUE」→ 取出所有 tuple
多表但沒 WHERE
- FROM EMPLOYEE, DEPARTMENT 但沒寫 WHERE
- 結果是 CROSS PRODUCT(笛卡兒積):
- 每個 EMPLOYEE tuple 會和每個 DEPARTMENT tuple 配對
- 筆數會爆炸(|EMPLOYEE| × |DEPARTMENT|)
星號*
- SELECT *:取出被選到的 tuple 的 所有欄位
- table.*:只取某張表的所有欄位
1 | -- 取出部門編號為 5 的所有員工完整資料 |
Tables as Sets / Bag(DISTINCT 與集合運算)
- SQL 查詢結果預設是 Bag(可重複)
- DISTINCT:把結果當成 Set(去重複)
1 | -- 可能會重複(因為不同員工可能同薪水) |
Tips : DISTINCT 是加在 SELECT 後面,代表「結果去重複」。
Set Operations(UNION / INTERSECT / EXCEPT)
三種集合運算(Set semantics,不允許重複)
- UNION:聯集
- INTERSECT:交集
- EXCEPT(有些 DBMS 用 MINUS):差集
Bag/Multiset 版本(允許重複)
- UNION ALL
- INTERSECT ALL
- EXCEPT ALL
使用限制:Type compatibility
- 兩邊查詢的輸出必須:
- 欄位數量相同
- 對應欄位型態相容
- 欄位順序要一致
LIKE / BETWEEN(字串樣式比對與區間條件)
LIKE:字串 pattern matching
-
%:任意長度(含 0)任意字元
-
_:剛好 1 個任意字元
1 | -- 地址包含 Houston,TX |
BETWEEN:範圍條件(含端點)
1 | WHERE Salary BETWEEN 30000 AND 40000 |
Tips : BETWEEN a AND b 等價於 >= a AND <= b。
Arithmetic Operations
-
可以在 SELECT 直接做 + - * /
-
範例:ProductX 專案的員工加薪 10%
1 | SELECT E.Fname, E.Lname, 1.1 * E.Salary AS Increased_sal |
ORDER BY(查詢結果排序)
- ORDER BY 放在查詢最後
- ASC:升冪(預設)
- DESC:降冪
1 | ORDER BY D.Dname DESC, E.Lname ASC, E.Fname ASC; |
SQL 查詢語法總整理
- 語法順序
1 | SELECT <attribute list> |
FROM(先決定資料來源與 join)
WHERE(先過濾 tuple)
GROUP BY(分組)
HAVING(過濾 group)
SELECT(投影/計算輸出欄位)
ORDER BY(最後排序輸出)
INSERT / DELETE / UPDATE
DML(改資料) 的核心指令:
-
INSERT:把「新的一筆 tuple/row」加進某個 table
-
UPDATE:把「符合條件的多筆 row」某些欄位改掉
-
DELETE:把「符合條件的多筆 row」刪掉
INSERT
最簡單 INSERT
1 | INSERT INTO EMPLOYEE |
- 值的順序很重要
- constraint 會自動檢查
你只想填一部分欄位
- 沒寫 NOT NULL → 會變 NULL
- 有 DEFAULT → 會用 DEFAULT
- NOT NULL 且沒 DEFAULT → 會失敗
1 | INSERT INTO EMPLOYEE (FNAME, LNAME, SSN) |
Bulk Loading
-
典型流程
- 先建一張「摘要表」
1
2
3
4
5CREATE TABLE DEPTS_INFO (
DEPT_NAME VARCHAR(10),
NO_OF_EMPS INTEGER,
TOTAL_SAL INTEGER
);- 用 INSERT…SELECT 把統計結果灌進去
1
2
3
4
5INSERT INTO DEPTS_INFO (DEPT_NAME, NO_OF_EMPS, TOTAL_SAL)
SELECT DNAME, COUNT(*), SUM(SALARY)
FROM DEPARTMENT, EMPLOYEE
WHERE DNUMBER = DNO
GROUP BY DNAME;
DELETE
DELETE 的本質
- 從某 table 移除 row
- 通常靠 WHERE 選要刪哪些 row
沒寫 WHERE:
代表刪掉整張表所有資料列(變空表)
範例
1 | DELETE FROM EMPLOYEE WHERE Lname = 'Brown'; |
UPDATE
UPDATE 基本結構(SET + WHERE)
1 | UPDATE <table> |
EXAMPLE
1 | UPDATE PROJECT |
WHERE 決定改幾筆
SET 決定改哪些欄位
一樣會被 FK / CHECK / NOT NULL 等 constraints 檢查
UPDATE + 子查詢 + 「右邊舊值、左邊新值」概念
1 | UPDATE EMPLOYEE |
= 右邊的 Salary:指「更新前的舊 Salary」
= 左邊的 Salary:指「更新後的新 Salary」
老實說我原本只是想要打有甚麼Function而已 , 但最後想一想還是把內容補完
希望大家可以看得懂我在打甚麼
如果有問題歡迎Gmail我歐!!!